Label: la respuesta que enseña al modelo qué significa acertar
 Equipo PuroIA
·15 de Septiembre, 2026
·4 min de lectura
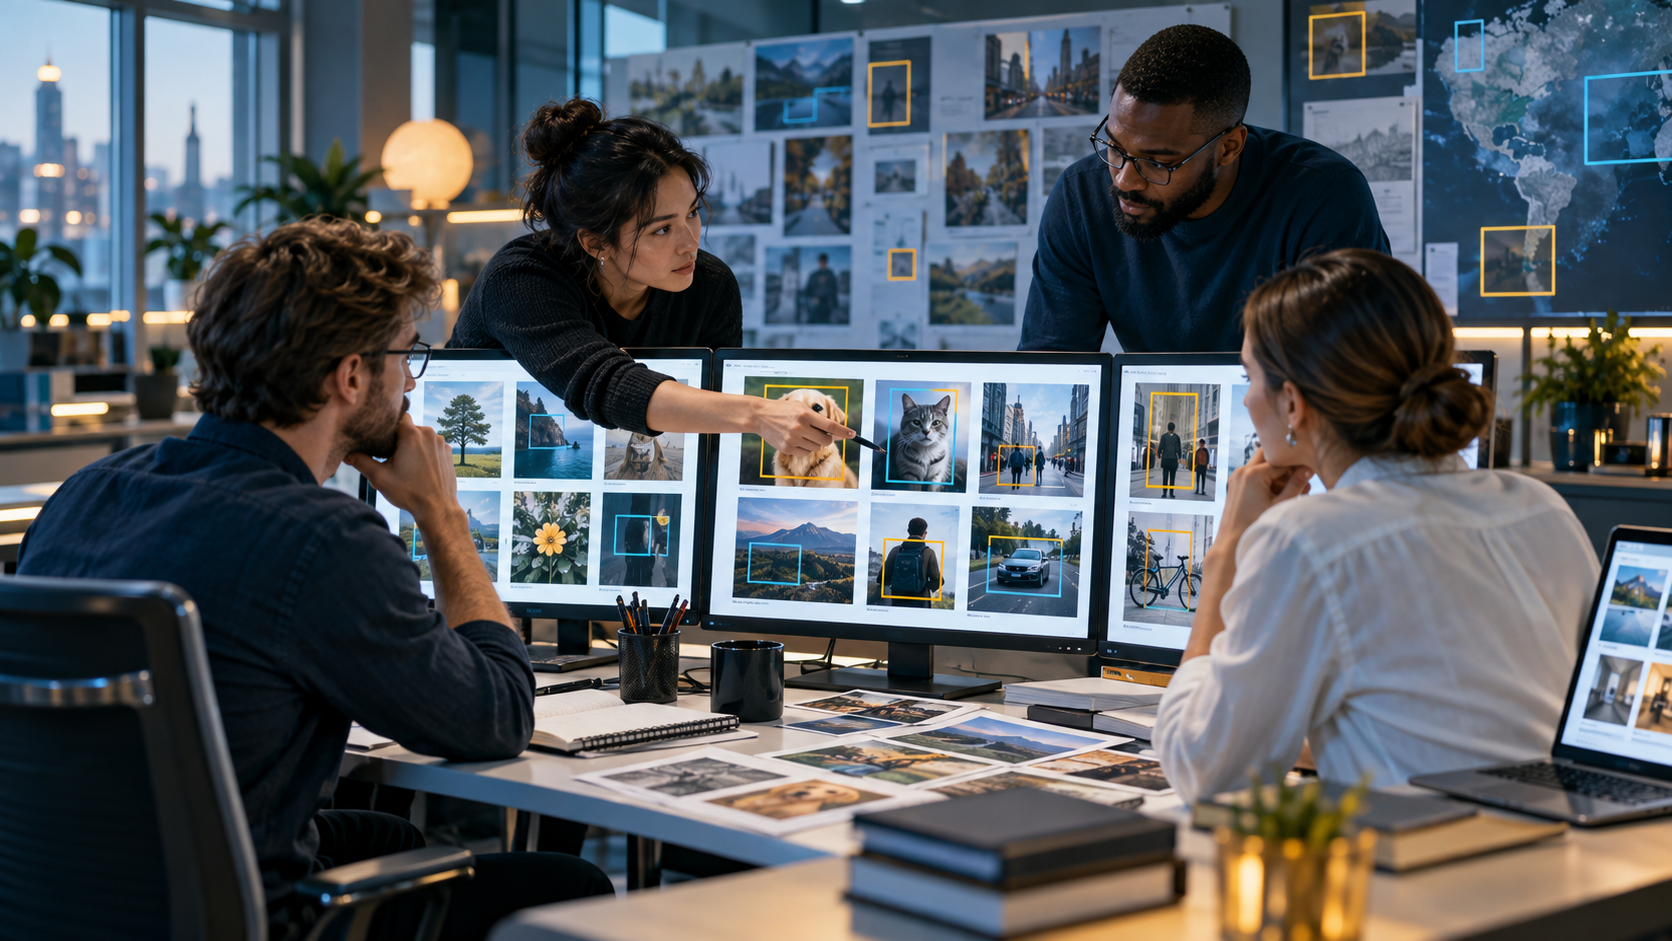
Una etiqueta es la respuesta que el modelo intenta aprender. En un conjunto de correos puede indicar spam o legítimo; en imágenes puede marcar la presencia de un defecto; en una predicción de demanda puede representar el valor que ocurrió después. La etiqueta parece un dato más, pero cumple una función especial: define qué significa acertar. Si la respuesta es ambigua, inconsistente o demasiado distante de la decisión real, el modelo puede entrenarse con precisión matemática hacia un objetivo equivocado.
Hay etiquetas directas e indirectas. Una etiqueta directa observa el resultado que interesa: si una transacción fue confirmada como fraudulenta después de una investigación, o si un equipo falló según un registro técnico. Una etiqueta indirecta usa un indicador relacionado, como una devolución para aproximar insatisfacción. Las aproximaciones pueden ser útiles cuando el resultado final tarda mucho en conocerse, pero deben comprobarse. Una devolución puede deberse a tamaño, logística o cambio de opinión, y no representar por sí sola la calidad del servicio.
Crear una etiqueta requiere una guía. Si varias personas revisan solicitudes y una marca “urgente” por el tono del texto mientras otra espera una amenaza explícita, sus decisiones reflejan criterios distintos. Documentar definiciones, ejemplos límite y reglas para casos desconocidos reduce la variabilidad. También conviene medir el acuerdo entre anotadores y revisar una muestra manualmente. Un desacuerdo no siempre es un error: puede revelar que la tarea necesita varias etiquetas, una categoría de incertidumbre o una decisión reservada a especialistas.
El costo de etiquetar aumenta con la dificultad. Identificar el idioma de un texto puede automatizarse con relativa facilidad; evaluar la gravedad de una lesión o la validez de un contrato requiere conocimiento profesional. Google recomienda analizar la capacidad de quienes etiquetan, el presupuesto, la cantidad de ejemplos y la necesidad de controles de calidad. Pagar más anotaciones no resuelve una instrucción confusa. La calidad del proceso depende del diseño, la formación, la revisión y la posibilidad de corregir una decisión.
La supervisión débil puede ayudar a crear etiquetas cuando no existe una anotación manual completa. Snorkel estudió técnicas para generar etiquetas mediante reglas, heurísticas y fuentes imperfectas, y luego entrenar modelos con esa información. Esta estrategia puede acelerar un proyecto, pero introduce supuestos que deben medirse. Una regla que busca palabras asociadas a fraude puede capturar patrones de lenguaje y omitir operaciones sin esa señal. Las etiquetas automáticas deben tratarse como evidencia con una confiabilidad conocida, no como verdad absoluta.
También hay que separar el evento de su registro. Una persona puede recibir una atención deficiente y aun así no presentar un reclamo; otra puede reclamar por un motivo que la etiqueta no distingue. Si el modelo aprende el comportamiento de quienes reportan y se aplica a toda la población, la relación puede cambiar. La etiqueta debe describir el fenómeno que importa, no solo la huella administrativa que quedó disponible. Esta diferencia suele explicar por qué un sistema funciona bien en los datos históricos y decepciona a los usuarios.
Las etiquetas pueden afectar a grupos de manera desigual. En una clasificación de contenido, ciertos dialectos pueden recibir más marcas de toxicidad porque los anotadores no reconocen el contexto. En un sistema de riesgo, una definición basada en decisiones pasadas puede reflejar prácticas que ya eran injustas. Revisar errores por subgrupos, conservar casos ambiguos y permitir apelaciones ayuda a detectar estos problemas. La neutralidad de una columna no se presume; se evalúa observando cómo fue construida y qué decisiones produce.
Una buena etiqueta enseña al modelo el propósito de la tarea con la mayor claridad posible. No tiene que eliminar toda complejidad, pero debe hacer explícitos los criterios, las fuentes y los límites. Cuando el resultado es discutible, el dataset debe conservar esa incertidumbre en vez de ocultarla detrás de un número. La IA supervisada aprende de respuestas humanas, automáticas o indirectas. Elegir esas respuestas es una responsabilidad de diseño que precede a cualquier entrenamiento.
Fuentes consultadas: Google — Datasets: Labels; Ratner et al. — Snorkel: Rapid Training Data Creation with Weak Supervision; Gebru et al. — Datasheets for Datasets
Hashtags: #Label #Etiquetas #DatosEtiquetados #AprendizajeSupervisado #Anotacion #MachineLearning
Prompt visual: Portada editorial fotorrealista futurista modernista, ejemplos de imágenes, documentos y registros reciben etiquetas cuidadosas en una mesa de anotación digital antes de entrar a un modelo, varias personas comparando criterios y resolviendo casos ambiguos, ambiente académico y preciso, azul petróleo, blanco y ámbar, formato horizontal, sin logos, sin texto legible, sin marcas de agua.
Escribimos sobre inteligencia artificial aplicada a empresas chilenas: qué sirve, qué no, y cómo mantener los datos adentro.


