Feature: cómo convertir el mundo en señales que un modelo pueda leer
 Equipo PuroIA
·15 de Septiembre, 2026
·4 min de lectura
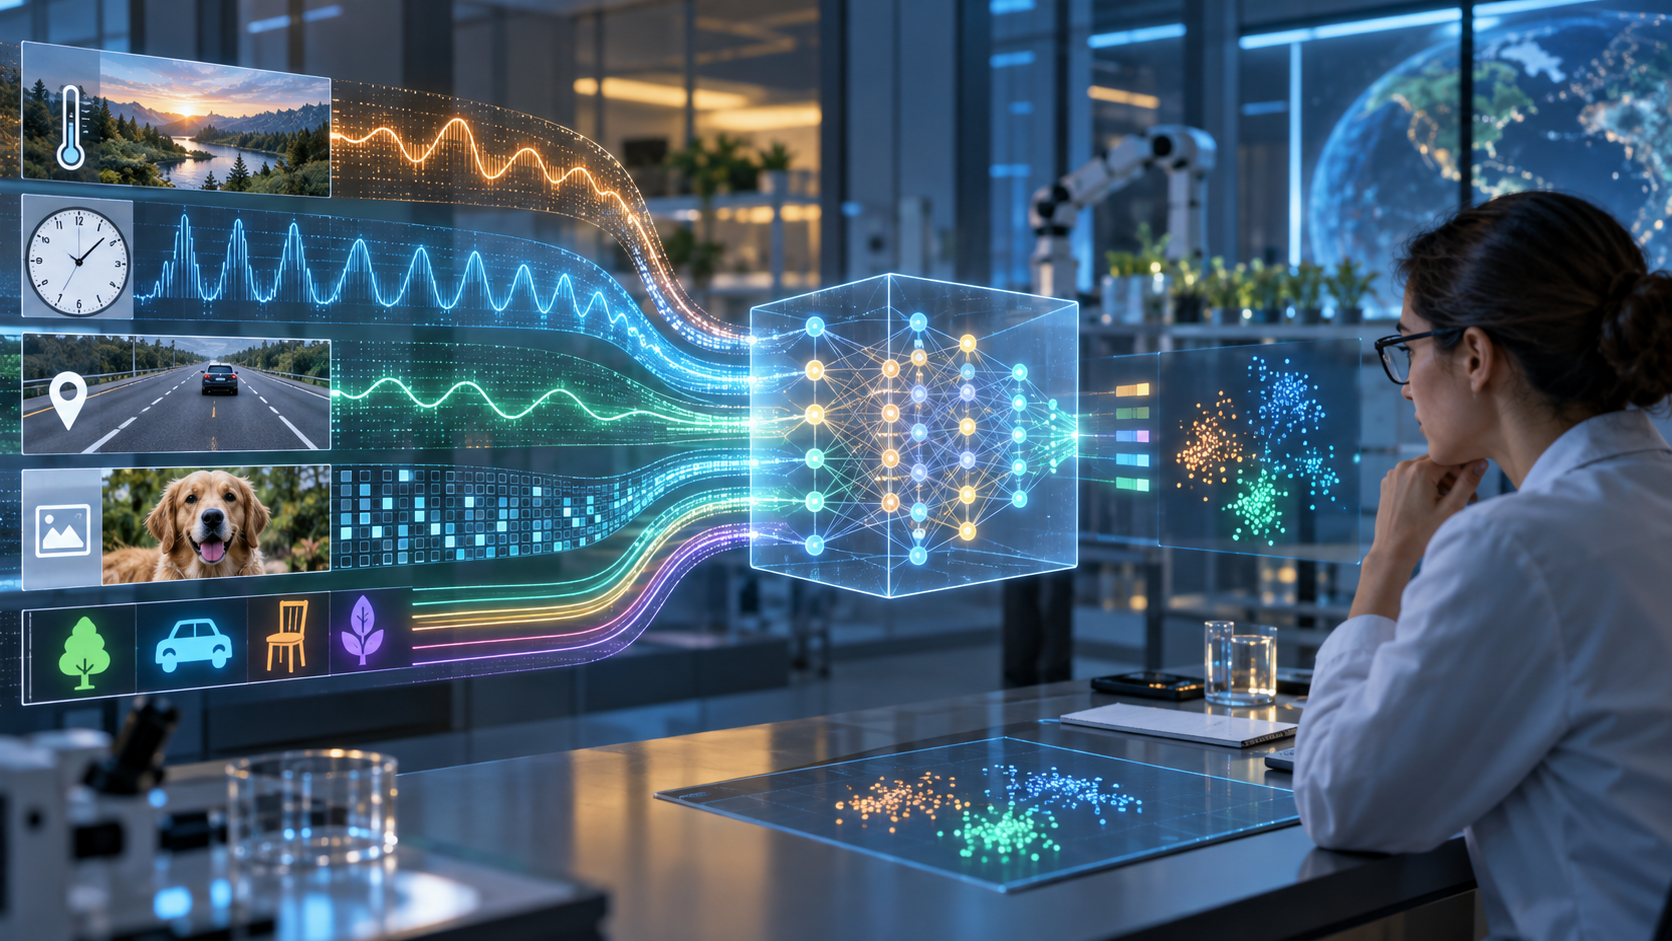
Una máquina no recibe el mundo como lo recibe una persona. Para un modelo, una conversación, una fotografía o una compra deben convertirse en representaciones que puedan procesarse matemáticamente. Una feature es una variable de entrada que describe algún aspecto de cada ejemplo. Puede ser una temperatura, una distancia, una categoría, una frecuencia, un conteo o una representación más compleja aprendida por una red. La elección de esas señales influye en qué relaciones puede encontrar el sistema.
Supongamos que se quiere estimar la demanda de un producto. El modelo podría recibir día de la semana, precio, inventario disponible, promociones, ubicación y ventas anteriores. Cada variable aporta una perspectiva diferente. La fecha puede convertirse en día, mes o temporada; una categoría puede representarse con indicadores; un texto puede transformarse en una secuencia de tokens o en un vector. La transformación no es un trámite mecánico. Decide qué información queda visible para el algoritmo y qué diferencias se pierden.
Las features deben estar disponibles en el momento de la predicción. Si el modelo anticipa una demora, utilizar la hora efectiva de entrega introduce información del futuro. El resultado de prueba será engañosamente bueno porque el sistema recibió una pista que no tendrá en producción. Esta fuga de información es frecuente cuando el equipo trabaja con una tabla histórica que mezcla variables conocidas antes del evento con variables registradas después. La fecha de observación y la fecha de disponibilidad deben documentarse con la misma atención que el nombre del campo.
La ingeniería de variables busca construir señales que expresen mejor el proceso. Una suma, una diferencia, un promedio móvil o una proporción puede ser más informativa que sus componentes aislados. En una serie temporal, el consumo reciente puede importar más que el total de un año. En un sistema de atención, el tiempo desde el último contacto puede capturar una situación distinta que el número bruto de llamadas. Estas transformaciones deben justificarse y probarse; agregar combinaciones indiscriminadamente puede aumentar el ruido y el sobreajuste.
Las variables categóricas presentan otro desafío. Una comuna, un tipo de producto o un canal de contacto no tiene un orden numérico natural. Asignarles simplemente los números uno, dos y tres puede hacer que el modelo interprete una distancia inexistente. Técnicas como one-hot encoding, hashing o embeddings permiten representar categorías de otra manera. La elección depende del modelo, del número de categorías, de la frecuencia de valores nuevos y del riesgo de que la codificación revele información sensible.
Una feature puede ser predictiva y aun así resultar problemática. El código postal puede correlacionarse con una decisión porque refleja acceso desigual a oportunidades; un identificador interno puede actuar como una memoria accidental de la etiqueta; el nombre de un archivo puede revelar la respuesta correcta. El análisis debe preguntar qué relación representa la variable y si esa relación es legítima para el propósito. La importancia estadística no es una autorización ética ni una prueba de causalidad.
Las representaciones cambian con el tiempo. Un producto nuevo, un término de moda o una modificación en el sistema de registro puede crear categorías que el modelo jamás vio. Si una feature deja de tener la misma distribución, la salida puede degradarse. Monitorear valores faltantes, rangos, frecuencias y categorías nuevas ayuda a detectar ese desplazamiento. También conviene versionar el código que transforma datos, porque un cambio silencioso en la preparación puede alterar el modelo aunque sus parámetros permanezcan intactos.
Pensar en features es aprender a formular preguntas sobre la realidad. ¿Qué estaba disponible antes de la decisión? ¿Qué variable es una señal estable y cuál es una coincidencia? ¿Qué información falta para ciertos grupos? ¿Qué ocurre si una fuente se interrumpe? Un modelo recibe números, pero esos números representan procesos, personas y decisiones. Una buena feature hace visible una relación relevante sin ocultar sus condiciones. El trabajo técnico empieza con datos; el trabajo intelectual consiste en entender qué significan.
Fuentes consultadas: Google — Feature vectors; Google — Machine Learning Glossary; scikit-learn — User Guide
Hashtags: #Feature #FeatureEngineering #Datos #MachineLearning #Variables #IA
Prompt visual: Portada editorial fotorrealista futurista modernista, objetos del mundo real —temperatura, tiempo, distancia, imágenes y categorías— transformándose en señales numéricas ordenadas que entran a un modelo de aprendizaje automático, analista examinando la representación, paleta azul, turquesa y ámbar, composición horizontal, sin logos, sin texto legible, sin marcas de agua.
Escribimos sobre inteligencia artificial aplicada a empresas chilenas: qué sirve, qué no, y cómo mantener los datos adentro.


