Dataset: el mapa de ejemplos que decide qué puede aprender una IA
 Equipo PuroIA
·16 de Septiembre, 2026
·4 min de lectura
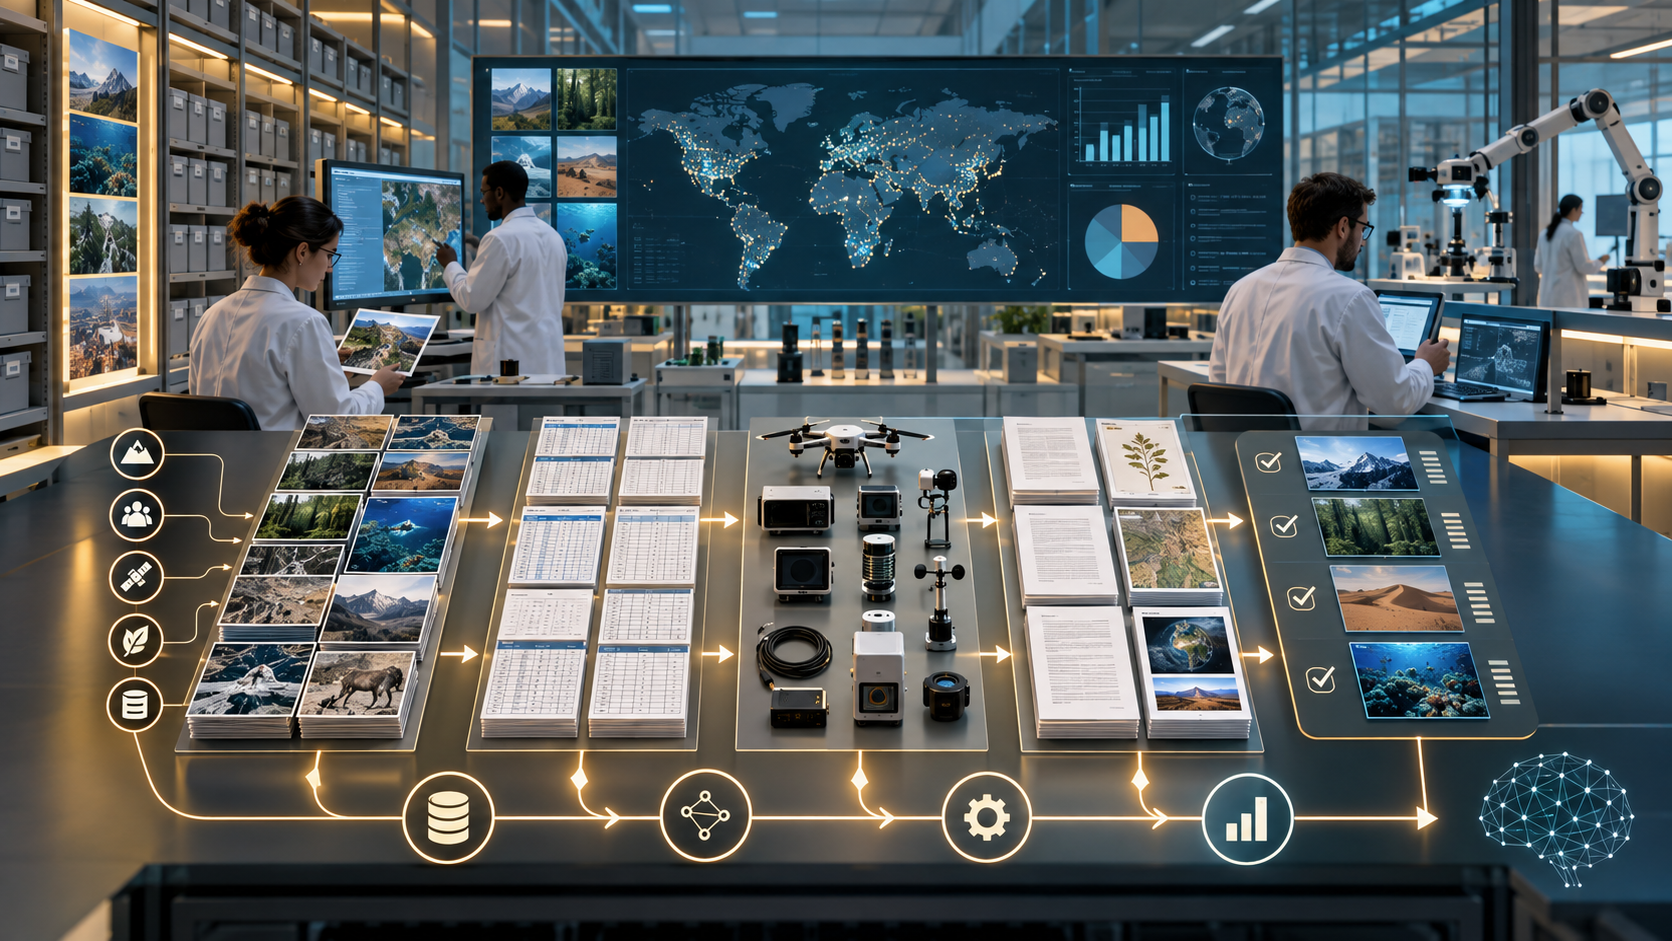
Un dataset no es una carpeta llena de archivos esperando que un algoritmo haga el trabajo difícil. Es una representación organizada de una parte del mundo, construida con decisiones sobre qué observar, qué descartar, cómo nombrar cada caso y para qué tarea se usará. Una colección de imágenes, registros de ventas, audios o documentos puede convertirse en un dataset cuando sus ejemplos tienen una estructura, un contexto y una relación definida con la pregunta que el modelo debe resolver.
La misma fuente puede ser útil para una tarea e inadecuada para otra. Un historial de compras sirve para estudiar demanda, pero no contiene necesariamente información suficiente para explicar por qué una persona dejó de usar un servicio. Un archivo de fotografías puede enseñar a reconocer objetos en ciertas condiciones de luz y fallar en otras. El dataset no es una copia neutral de la realidad: es un mapa con fronteras. Lo que queda fuera de esas fronteras puede convertirse en el principal límite del sistema.
La calidad tiene varias dimensiones. Los datos deben ser correctos para la tarea, suficientemente completos, coherentes entre sí y representativos de las situaciones donde se usará el modelo. Los duplicados pueden inflar artificialmente el rendimiento; los valores faltantes pueden esconder una diferencia entre grupos; los registros tomados en una sola temporada pueden perder vigencia. Revisar distribuciones, muestras y relaciones entre campos suele revelar problemas que una métrica de entrenamiento jamás muestra.
El origen importa por razones técnicas y éticas. Hay que saber quién produjo el dato, con qué instrumento, bajo qué condiciones y con qué permisos. Un documento obtenido para una finalidad puede no ser apropiado para entrenar otra herramienta. Las imágenes y voces pueden incluir información personal; los registros empresariales pueden contener secretos comerciales. La gobernanza del dataset debe describir acceso, retención, licencias, anonimización y mecanismos para retirar o corregir ejemplos.
La división del dataset separa funciones. Los ejemplos de entrenamiento permiten ajustar parámetros; los de validación ayudan a elegir configuraciones; los de prueba ofrecen una medición final sobre casos reservados. Si hay datos relacionados entre sí, una división aleatoria puede ser engañosa. Varias fotografías del mismo objeto, registros de un mismo cliente o mediciones consecutivas pueden terminar en conjuntos distintos y hacer que el modelo parezca generalizar cuando en realidad reconoce una repetición. La unidad de separación debe corresponder al riesgo real.
Documentar un dataset evita que el conocimiento desaparezca cuando cambia el equipo. Una ficha útil registra propósito, composición, fuentes, métodos de recolección, criterios de exclusión, etiquetas, limitaciones y usos que deben evitarse. El trabajo Datasheets for Datasets convirtió esta necesidad en una propuesta concreta para mejorar la comunicación entre quienes crean y quienes consumen datos. La documentación no corrige un dataset defectuoso, pero permite detectarlo antes de que se transforme en una decisión automatizada.
Para una organización pequeña, comenzar bien puede ser tan simple como guardar una muestra representativa, crear un diccionario de campos y anotar cada transformación aplicada. Si se eliminan filas, hay que conocer el motivo. Si se completan valores faltantes, conviene registrar el método. Si se cambia una etiqueta, debe existir una versión nueva y una explicación. Esa disciplina permite reproducir un experimento y comparar si una mejora provino del modelo o de una modificación invisible en los datos.
Un dataset valioso no es necesariamente el más grande. Es el que mantiene una conexión clara entre ejemplos, contexto y decisión. Cuando sus límites están documentados, el equipo puede saber cuándo el modelo está fuera de alcance y cuándo debe recolectar más evidencia. La inteligencia artificial aprende de lo que recibe, pero la responsabilidad comienza mucho antes: en la forma en que una organización decide qué merece convertirse en ejemplo.
Fuentes consultadas: Google — Datasets, generalization, and overfitting; Gebru et al. — Datasheets for Datasets; NIST — AI Risk Management Framework
Hashtags: #Dataset #Datos #MachineLearning #CalidadDeDatos #Gobernanza #IA
Prompt visual: Portada editorial fotorrealista futurista modernista, un gran mapa de datos formado por fotografías, tablas, sensores y documentos organizados en capas, investigadores revisando su origen y representación antes de alimentar un sistema de IA, atmósfera de archivo científico y precisión, azul petróleo, marfil y ámbar, formato horizontal, sin logos, sin texto legible, sin marcas de agua.
Escribimos sobre inteligencia artificial aplicada a empresas chilenas: qué sirve, qué no, y cómo mantener los datos adentro.


