Deep Learning: por qué las redes profundas transforman datos en representaciones
 Equipo PuroIA
·31 de Agosto, 2026
·4 min de lectura
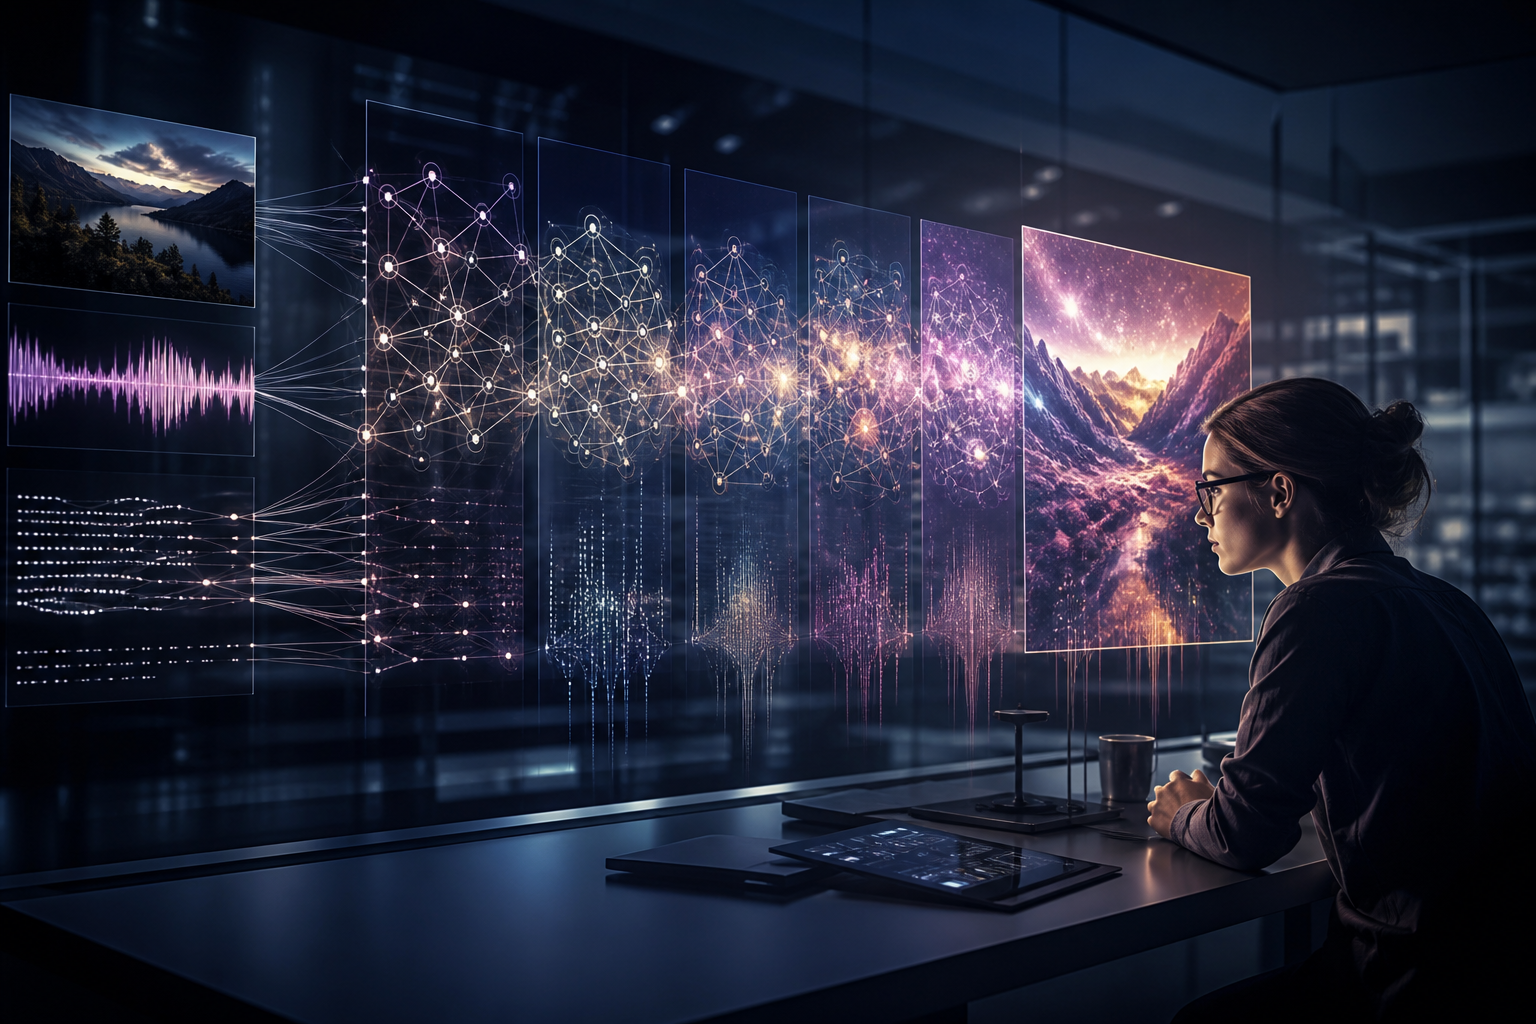
El aprendizaje profundo recibe su nombre de una idea sencilla: una red neuronal puede organizar muchos cálculos en capas y aprender representaciones progresivamente más útiles. En una imagen, las primeras capas pueden responder a bordes o contrastes; capas posteriores pueden combinar esas señales en formas; las siguientes pueden reconocer partes y objetos. En lenguaje, una red puede transformar símbolos en representaciones que capturan relaciones de contexto. La máquina no recibe una lista completa de conceptos: ajusta transformaciones a partir de muchos ejemplos.
Una red neuronal está formada por unidades que reciben valores, los combinan con pesos y producen nuevas señales. Cada capa aplica una transformación y una función no lineal. Si todas fueran transformaciones lineales, apilarlas no añadiría una capacidad sustancial; la no linealidad permite construir relaciones más complejas. Durante el entrenamiento, la retropropagación calcula cómo contribuyó cada parámetro al error y un optimizador modifica los pesos. El proceso repite esa corrección hasta que el modelo mejora según la función elegida.
La profundidad no es una garantía automática de inteligencia. Una red grande puede memorizar, ser difícil de entrenar o aprender una señal equivocada. Necesita datos representativos, una función de pérdida adecuada, recursos de cómputo y un diseño que controle el sobreajuste. También importa cómo se prepara la entrada. Una imagen puede cambiar de escala, un audio puede contener ruido y un texto puede usar palabras que no aparecían en la muestra. La representación numérica es parte del problema, no una etapa neutral que se resuelve sola.
El aprendizaje profundo avanzó gracias a una combinación de factores. Las unidades de procesamiento gráfico hicieron posible entrenar operaciones matriciales a gran escala. Los conjuntos de datos crecieron y las arquitecturas se especializaron para distintos tipos de señales. Las técnicas de optimización y regularización mejoraron la estabilidad. Ningún factor explica por sí solo el salto de rendimiento. Un modelo puede tener una arquitectura moderna y aun así fallar si las etiquetas son ruidosas o si la tarea real difiere de la prueba publicada.
En visión computacional, las redes profundas pueden detectar objetos, segmentar superficies o comparar imágenes. En voz, transforman ondas en representaciones de sonidos y palabras. En lenguaje, aprenden relaciones entre tokens y contextos. Estas capacidades son útiles porque evitan diseñar manualmente todos los rasgos relevantes. Un sistema de inspección industrial, por ejemplo, puede aprender la textura asociada a una microfisura a partir de imágenes revisadas por especialistas. Pero debe evaluarse con nuevas cámaras, otros materiales y condiciones de iluminación distintas.
La opacidad aumenta con la escala. Es posible visualizar activaciones, estudiar ejemplos cercanos o medir qué cambios modifican una salida, pero esas herramientas no convierten una red profunda en una lista de reglas. La explicación debe incluir también el conjunto de datos, la definición de la tarea, los casos donde el sistema no funciona y la forma en que la predicción se usa en la operación. Mostrar un mapa de atención sin contexto puede dar una falsa sensación de comprensión.
El costo de inferencia es una consideración práctica. Redes profundas grandes pueden entregar calidad, pero consumen memoria, energía y tiempo. Una empresa puede necesitar reducir el modelo, usar cuantización, procesar en el borde o aceptar una respuesta menos compleja. El diseño responsable compara precisión con latencia, costo y privacidad. Un detector que responde en una fábrica aislada puede ser más valioso que uno ligeramente mejor que depende de una conexión inestable.
Deep learning amplió el tipo de información que una máquina puede procesar, pero no abolió los límites del aprendizaje. Las capas construyen representaciones a partir de la experiencia disponible; no garantizan sentido común, intención ni conocimiento actualizado. Para que una red profunda sea confiable, necesita una tarea bien planteada, datos examinados, pruebas fuera de muestra y un lugar definido dentro de un sistema humano. La profundidad ayuda a representar; la responsabilidad decide para qué.
Fuentes consultadas: Goodfellow, Bengio y Courville — Deep Learning; LeCun, Bengio y Hinton — Deep learning; TensorFlow — Keras Sequential model
Hashtags: #DeepLearning #AprendizajeProfundo #RedesNeuronales #VisionComputacional #Lenguaje #InteligenciaArtificial
Prompt visual: Portada editorial fotorrealista futurista modernista, varias capas de una red neuronal profunda transformando una imagen, una onda sonora y fragmentos abstractos de lenguaje en representaciones luminosas, investigador observando las conexiones, profundidad visual marcada, azul noche, magenta suave y dorado, composición horizontal, sin logos, sin texto legible, sin marcas de agua.
Escribimos sobre inteligencia artificial aplicada a empresas chilenas: qué sirve, qué no, y cómo mantener los datos adentro.


